View Summary Pdf File Gene model: Cs_Cb2.06g275360.m01
IDENTIFICATION
- Species Name
- ARF
- Locus:
- Cs_Cb2.06g275360.m01
- Gene Model:
- Cs_Cb2.06g275360.m01
- Description:
- CsARF-20
- Family:
- ARF
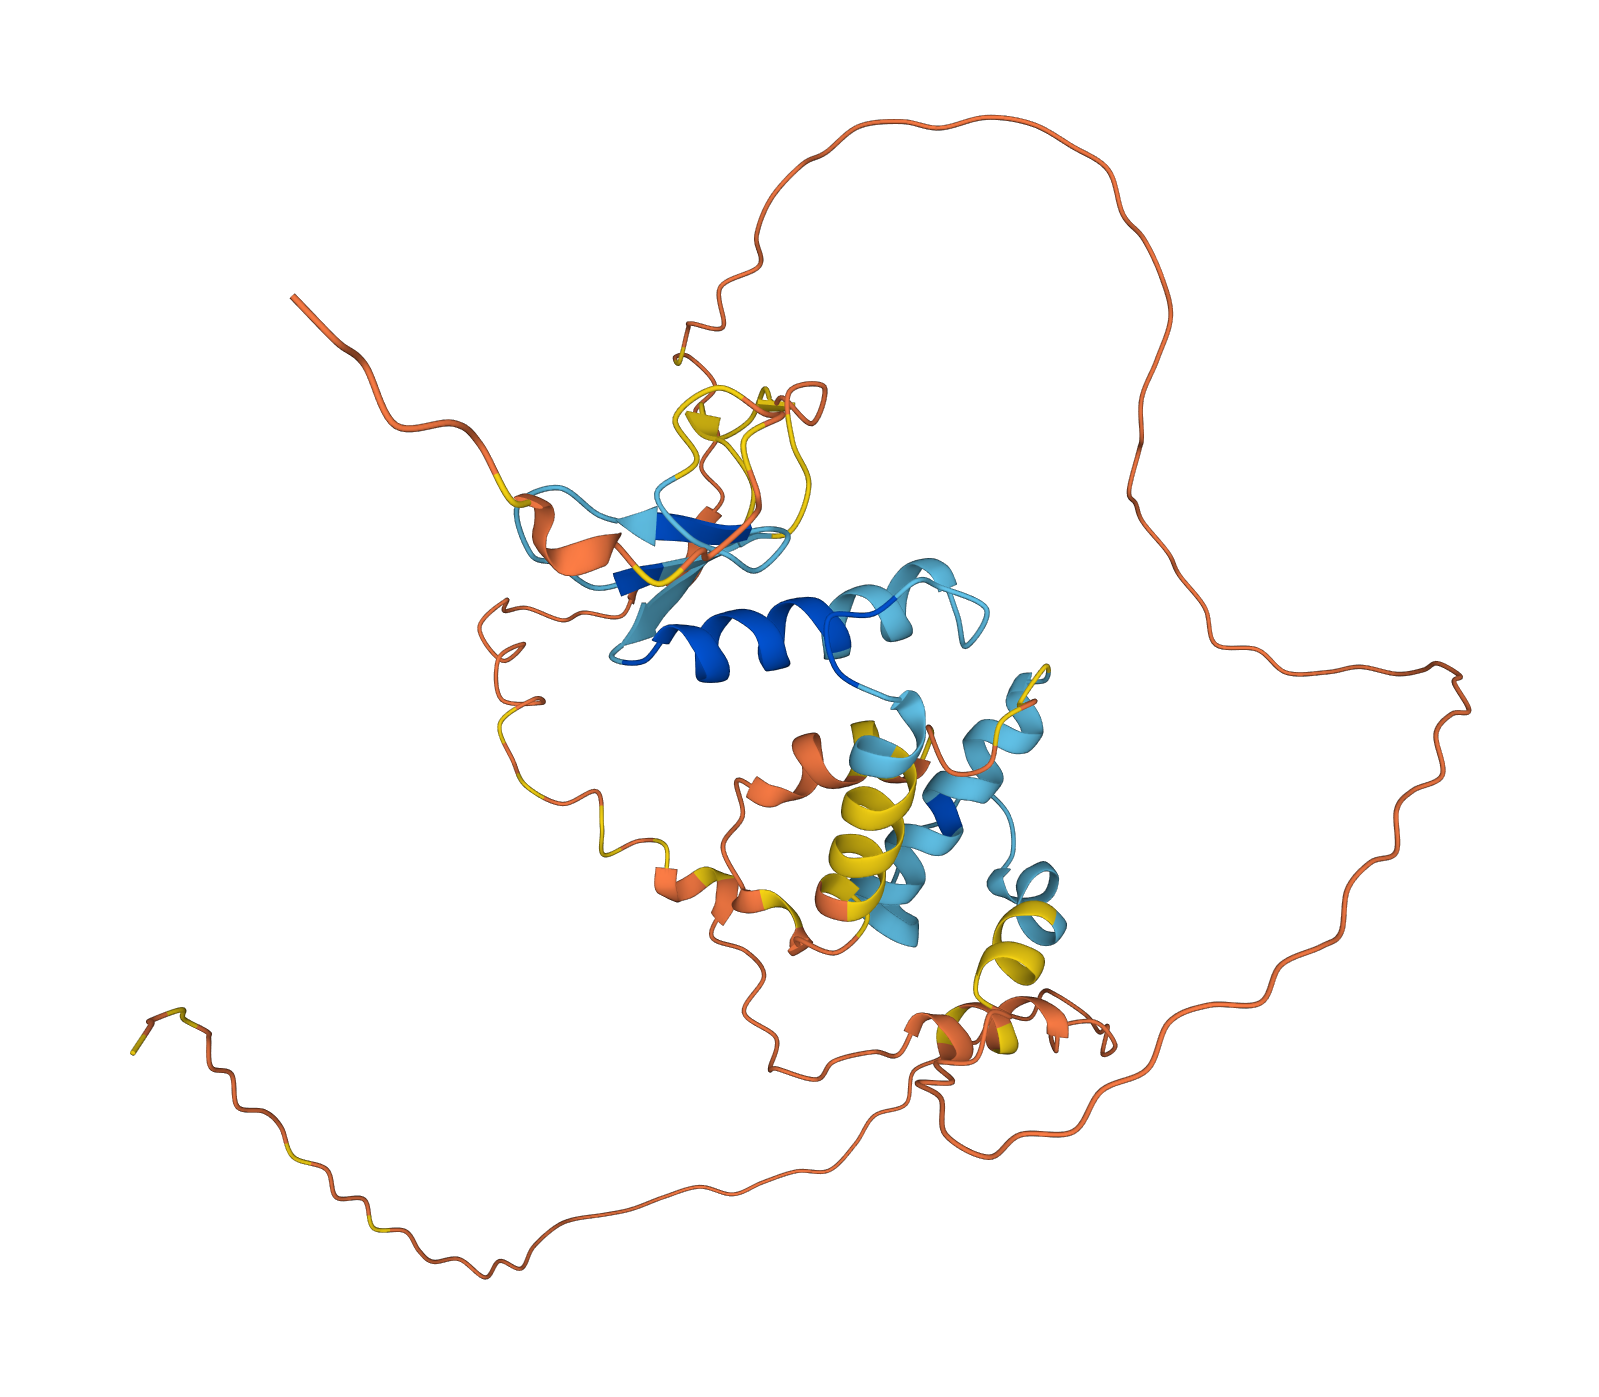
- 3D Structure:
- CsAP2-20
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsARF-20
MNEERVQIIGNDMIIDSSLWHACAGRLVHVPPVNSTVSYFPQGHFEHAGM
ENTDDAIATASRIPWRIQCRVTSVELKMDSRTEEVYTKIHLNPIVTNNNN
STDDDKDYALSESLNLFGRSQFLTKVLTQSDANNGGGFSVPKKLAEIIFP
PLNYKITKPGIENLPSQDILARDYRGNIWKFRHVYRGNPLRHLLTTGWSK
FVTAKQVVSGDTIVFGRDDNGDVYVGIRRVRRARWQGRIRAESVLEAARL
AAIGRGFEVRYYPSSTTTEFCVVDSVVNAMKRKMVNEFGAGTRIKMAFET
LNSTGVEPVGWYKGSIESVEDVDPNHWPGSLWRRLKVRWDVDAVNLRKQI
NPWLVQVVSTRVIQTYDRKRGGEQLEESNHVVKKQTVYLFGAPIGESKRR
SG - CDS (Coding Sequence):
-
>CsARF-20
ATGAACGAAGAAAGAGTTCAGATAATCGGGAACGACATGATCATAGATTC
CTCTCTTTGGCATGCCTGTGCCGGAAGACTAGTTCATGTTCCTCCGGTCA
ACTCTACGGTATCTTACTTCCCTCAAGGTCACTTCGAACACGCCGGAATG
GAAAACACCGATGACGCCATAGCCACGGCGAGTAGAATTCCATGGAGGAT
TCAATGCCGAGTCACGTCCGTGGAGTTAAAGATGGATTCAAGAACTGAAG
AGGTTTACACCAAGATTCATCTCAACCCAATAGTGACCAATAATAATAAT
TCTACTGATGATGATAAAGACTACGCTTTGAGCGAGAGTTTGAATTTATT
TGGGAGATCCCAATTTCTTACCAAAGTCCTTACTCAATCGGACGCGAACA
ATGGCGGGGGTTTCTCTGTACCGAAAAAACTAGCGGAGATAATATTCCCA
CCATTAAATTACAAAATTACTAAACCTGGTATTGAAAATCTTCCGTCTCA
GGATATTTTGGCGAGGGATTACAGAGGCAATATTTGGAAATTCAGGCATG
TTTATAGGGGGAATCCTCTGCGGCACTTGTTGACAACTGGATGGAGTAAA
TTCGTTACAGCCAAGCAAGTGGTTTCTGGAGACACGATCGTGTTCGGGAG
GGATGACAATGGAGATGTCTATGTTGGAATAAGGCGTGTTAGGAGGGCAA
GGTGGCAAGGAAGAATTAGGGCTGAAAGTGTTCTAGAAGCTGCAAGACTA
GCTGCCATTGGGAGAGGTTTTGAAGTTAGGTATTACCCGAGTAGTACCAC
AACAGAGTTTTGTGTTGTGGATTCGGTGGTTAATGCAATGAAGAGGAAGA
TGGTGAATGAGTTTGGGGCTGGGACAAGGATCAAGATGGCTTTCGAGACT
TTAAATTCGACTGGAGTGGAACCAGTGGGCTGGTACAAGGGTTCTATTGA
GTCTGTTGAAGATGTTGACCCGAATCACTGGCCTGGTTCTTTATGGCGCC
GTCTTAAGGTGAGGTGGGATGTTGATGCTGTAAATTTAAGGAAGCAAATT
AATCCATGGTTGGTCCAAGTGGTGAGCACACGTGTCATTCAAACCTATGA
CCGCAAACGTGGAGGCGAGCAATTGGAGGAATCCAATCACGTTGTAAAGA
AGCAGACAGTCTATCTATTTGGTGCACCCATTGGAGAATCCAAGAGGAGA
TCAGGATAA - Nucleotide:
-
>CsARF-20
ATGAACGAAGAAAGAGTTCAGATAATCGGGAACGACATGATCATAGATTC
CTCTCTTTGGCATGCCTGTGCCGGAAGACTAGTTCATGTTCCTCCGGTCA
ACTCTACGGTATCTTACTTCCCTCAAGGTCACTTCGAACACGCCGGAATG
GAAAACACCGATGACGCCATAGCCACGGCGAGTAGAATTCCATGGAGGAT
TCAATGCCGAGTCACGTCCGTGGAGTTAAAGATGGATTCAAGAACTGAAG
AGGTTTACACCAAGATTCATCTCAACCCAATAGTGACCAATAATAATAAT
TCTACTGATGATGATAAAGACTACGCTTTGAGCGAGAGTTTGAATTTATT
TGGGAGATCCCAATTTCTTACCAAAGTCCTTACTCAATCGGACGCGAACA
ATGGCGGGGGTTTCTCTGTACCGAAAAAACTAGCGGAGATAATATTCCCA
CCATTAAATTACAAAATTACTAAACCTGGTATTGAAAATCTTCCGTCTCA
GGATATTTTGGCGAGGGATTACAGAGGCAATATTTGGAAATTCAGGCATG
TTTATAGGGGGAATCCTCTGCGGCACTTGTTGACAACTGGATGGAGTAAA
TTCGTTACAGCCAAGCAAGTGGTTTCTGGAGACACGATCGTGTTCGGGAG
GGATGACAATGGAGATGTCTATGTTGGAATAAGGCGTGTTAGGAGGGCAA
GGTGGCAAGGAAGAATTAGGGCTGAAAGTGTTCTAGAAGCTGCAAGACTA
GCTGCCATTGGGAGAGGTTTTGAAGTTAGGTATTACCCGAGTAGTACCAC
AACAGAGTTTTGTGTTGTGGATTCGGTGGTTAATGCAATGAAGAGGAAGA
TGGTGAATGAGTTTGGGGCTGGGACAAGGATCAAGATGGCTTTCGAGACT
TTAAATTCGACTGGAGTGGAACCAGTGGGCTGGTACAAGGGTTCTATTGA
GTCTGTTGAAGATGTTGACCCGAATCACTGGCCTGGTTCTTTATGGCGCC
GTCTTAAGGTTTGTATATTCATCTCGATCGATCTTATAATACTTGCAATT
AAATAATATGATGCTTATTAATTGATAGATATGTCTCTCTTTTTGGAAAG
TTCTAGGATGGAAATTTAAGCATTGGTATACAGAATTAAGTACCATAATT
AATATTAGACATTTAATACATCATGCAACTTTTGGACCAATTAAATATAG
GTTTTTACTGTACTAAAATCGAAAGATTCAAACCCATATGTGTTATTTTA
GAATATTAATAGGTGTACACACAAATCACACCTAAACTTATTACTCACAA
ATACGGGATCCAATTAGAAAATCATCCTCCAATCTAATCTAATTAGACCT
CAAAATTTTATATAATCTAATCCAATTACCAATTTATATCTAATTACACA
CCTAAATTATAATATTAACTTAGAAATATAAAAAACAAGAATACGTAAAA
ACTAAGTATGACATTTTATTTCAGTTTATAATTCATAGGCAAAAATTTTA
AATAATTAAAAGAACAATATTTTAAATAAAAAAATAAAATAAAACATCAT
GAAAATAATTATACAAAACAATCAAGTATTACAAATTCAACACACACACA
AATCTAATAAAATTATAATTTAAATATATATTATATTTTTCTATATTTTT
ATTATATAAATAATTTTTTAACATATATAAATGTAATTGGATTGGATCAG
TTTTTAATTAAATAACTGATCCAATCCAATTAGAATCCAATTTTTAACAT
CTAATCTAATTCCTGTCTATTTTTTTGTAATTGGATTAAATTGGATGGGT
TCAATCAAATATTGGATTGAATGATATCCACTCCAGTCACAGTTATGTAG
TAATTAATTTTGATTAATCATGTTTATTATTAATTAAAAGTGACTTGTCT
AATGTGTTAAGTTTGTGGGTCTGAAATCTACATTTAAGTATTTAAAACTA
TTTTAATATTTATTAACAGTGTCTTAAATAACTAATAGAAAAATAAAGTA
AAATTATTAAATGTTGAAAATATAAATGGAGCTGTAAAAATGTTCTATTG
TAACAAAAACTCTAAGGACATCTATAATGTCTAGGACTACTCTTACTATG
TTAATGTATCATATTGCTATAAGTACCAAATAACACCTCTTGTTACAAAA
ATGCTAAAAGACAGCCGTACTGTCTAATGTAAAATTACCCATTGTTCTTT
TACTTACTTACTATGATAAATTGATTATGTAATGATAGGTGAGGTGGGAT
GTTGATGCTGTAAATTTAAGGAAGCAAATTAATCCATGGTTGGTCCAAGT
GGTGAGCACACGTGTCATTCAAACCTATGACCGCAAACGTGGAGGCGAGC
AATTGGAGGAATCCAATCACGTTGTAAAGAAGCAGACAGTCTATCTATTT
GGTGCACCCATTGGAGAATCCAAGAGGAGATCAGGATAA