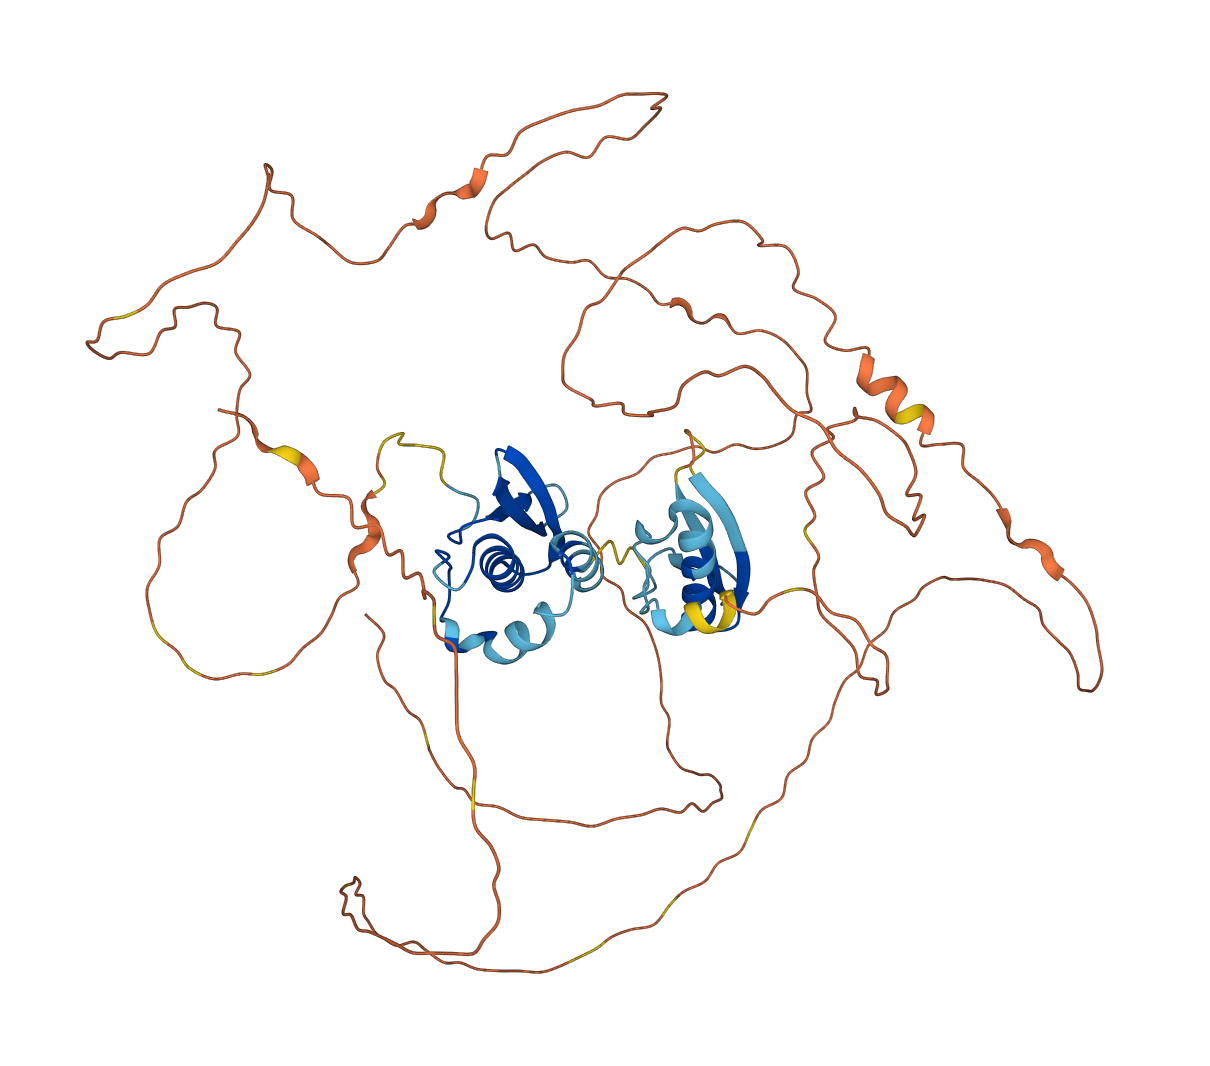
View Summary Pdf File Gene model: Cs_Cb2.04g152680.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.04g152680.m01
- Gene Model:
- Cs_Cb2.04g152680.m01
- Description:
- CsAP2-13
- Family:
- AP2
- 3D Structure:
- CsAP2-13
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-13
MWDLNDCPDQRRDDESEGCSSQKTSVDGDDEKGKRVGSVSNSSSSAVVIE
DGSDEEYGMGTRSNMMMMMKKRSGSNSKIFGFSVTHNELEEEEEDFSMET
DPSPVTRNFFPVEESEMGPSSSILVGGPTDVGGGNIVDGFPRAAWVGVKF
CQSDSLGPGPVKPSSMEVSQPMKKSRRGPRSRSSQYRGVTFYRRTGRWES
HIWDCGKQVYL - CDS (Coding Sequence):
-
>CsAP2-13
ATGTGGGATCTTAATGACTGTCCTGATCAGAGACGAGACGACGAATCCGA
AGGTTGTTCGTCCCAGAAAACCTCCGTCGATGGAGACGACGAAAAGGGTA
AACGGGTCGGATCCGTCTCGAATTCGAGCTCATCGGCGGTTGTAATCGAG
GACGGATCGGACGAAGAGTACGGAATGGGTACCCGAAGTAACATGATGAT
GATGATGAAGAAGCGTAGTGGTAGCAATAGCAAGATATTTGGGTTCTCAG
TGACCCACAACGAGCTTGAAGAAGAAGAAGAAGACTTCTCCATGGAAACA
GACCCATCTCCAGTAACCCGAAACTTCTTTCCGGTGGAAGAATCAGAAAT
GGGACCTTCCTCCTCCATCTTAGTCGGCGGCCCCACCGATGTGGGTGGTG
GAAATATAGTGGATGGGTTTCCCCGGGCCGCATGGGTCGGAGTGAAGTTC
TGCCAGTCCGATTCACTGGGCCCAGGCCCAGTAAAGCCCTCTTCTATGGA
AGTTTCTCAGCCCATGAAGAAGAGCCGTCGTGGGCCCAGGTCCAGAAGCT
CTCAATACCGCGGCGTTACCTTTTACCGGCGAACTGGCCGGTGGGAGTCC
CATATATGGGATTGTGGAAAACAAGTTTATCTGG - Nucleotide:
-
>CsAP2-13
ATGTGGGATCTTAATGACTGTCCTGATCAGAGACGAGACGACGAATCCGA
AGGTTGTTCGTCCCAGAAAACCTCCGTCGATGGAGACGACGAAAAGGGTA
AACGGGTCGGATCCGTCTCGAATTCGAGCTCATCGGCGGTTGTAATCGAG
GACGGATCGGACGAAGAGTACGGAATGGGTACCCGAAGTAACATGATGAT
GATGATGAAGAAGCGTAGTGGTAGCAATAGCAAGATATTTGGGTTCTCAG
TGACCCACAACGAGCTTGAAGAAGAAGAAGAAGACTTCTCCATGGAAACA
GACCCATCTCCAGTAACCCGAAACTTCTTTCCGGTGGAAGAATCAGAAAT
GGGACCTTCCTCCTCCATCTTAGTCGGCGGCCCCACCGATGTGGGTGGTG
GAAATATAGTGGATGGGTTTCCCCGGGCCGCATGGGTCGGAGTGAAGTTC
TGCCAGTCCGATTCACTGGGCCCAGGCCCAGTAAAGCCCTCTTCTATGGA
AGTTTCTCAGCCCATGAAGAAGAGCCGTCGTGGGCCCAGGTCCAGAAGCT
CTCAATACCGCGGCGTTACCTTTTACCGGCGAACTGGCCGGTGGGAGTCC
CATATATGGTCAGTACAGTAATTTTAGTTTTTTTTTTTTTTTTTTTTTTT
TTTTTTCCCTTCTTTTCTATAAATATGTTTTTTTATATTGGACAATTTTG
TAAGCATTTGAATCTAATCAATTATATTTTGGGGTATTTCTTGTCTTTCT
TTTTTTGATTTTGTCCTTCCTTATACAGGGATTGTGGAAAACAAGTTTAT
CTGG