View Summary Pdf File Gene model: Cs_Cb2.03g120950.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.03g120950.m01
- Gene Model:
- Cs_Cb2.03g120950.m01
- Description:
- CsAP2-10
- Family:
- AP2
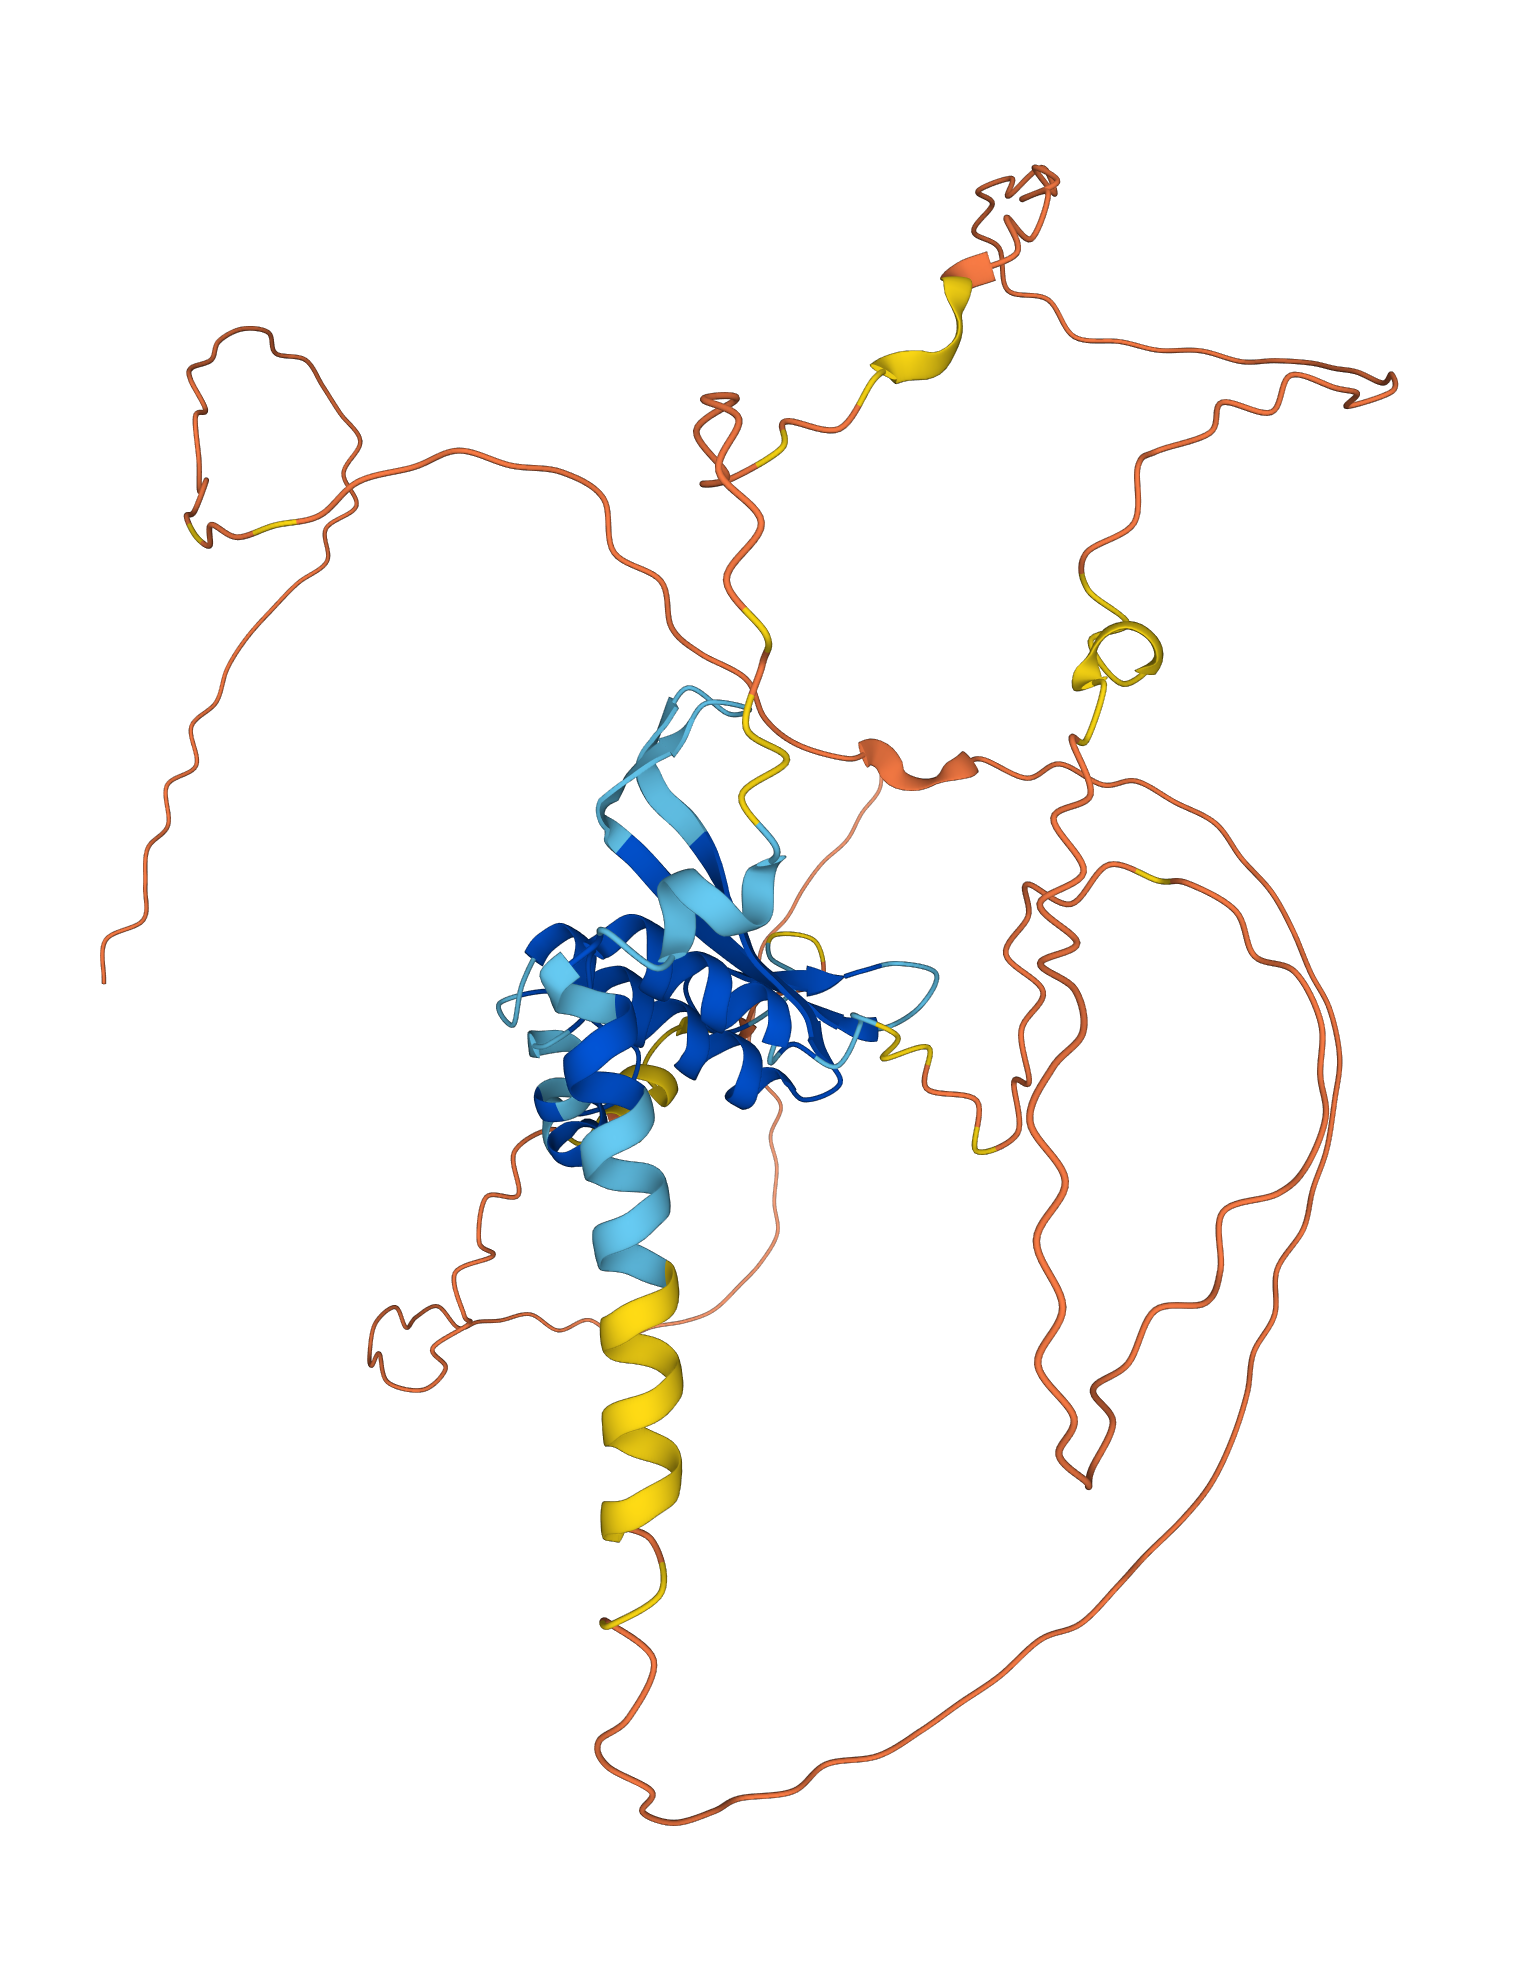
- 3D Structure:
- CsAP2-10
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-10
MMASSSSDPGLKPESSSGGGGGGETSEAVIANDQLLLYRGLKKAKKERGC
TAKERISKMPPCAAGKRSSIYRGVTRHRWTGRYEAHLWDKSTWNQNQNKK
GKQGAYDDEEAAARAYDLAALKYWGPGTLINFPVTDYARDLEEMQNVSRE
EYLASLRRKSSGFSRGISKYRALSSRWEPSFGRMAGSEYLSSIHYGPGDD
LATDSEFVGSLCFERKIDFTNYIKWWGPNKNRQGEASVKSSEDAKFGCVG
DLGGELKPLEWAVKTTEPYQMPRLGVSPEGKQHKSSKVSALSILSRSPAY
KSLQEKASKKEETNAENDENKNKNTMSKLDYGKAIEKSTNHDGASDRYGA
ELGMSEGLSLQRNINMFPLSPLLNAPLLTNYNTIDPLVDPIIWTSLAPVL
PGGLSRTSEVTKTETSSSFSLYQQGE - CDS (Coding Sequence):
-
>CsAP2-10
ATGATGGCTTCTTCTTCCTCTGATCCTGGTTTAAAGCCGGAATCTAGTTC
CGGTGGCGGTGGTGGAGGAGAGACTTCGGAGGCTGTGATTGCGAATGATC
AGCTTTTGTTATACAGAGGATTGAAAAAAGCGAAGAAAGAAAGGGGTTGT
ACGGCCAAAGAGAGAATCAGTAAAATGCCTCCATGTGCTGCTGGAAAAAG
GAGCTCCATTTACCGTGGAGTTACCAGGCATAGATGGACTGGTCGTTATG
AAGCTCATCTTTGGGATAAAAGTACTTGGAACCAAAACCAGAATAAGAAG
GGAAAGCAAGGGGCTTATGATGATGAGGAGGCTGCTGCTCGAGCTTATGA
TCTTGCTGCCTTAAAATATTGGGGTCCTGGTACTCTAATTAACTTTCCAG
TCACAGATTACGCGAGGGATCTTGAAGAAATGCAAAATGTTTCGCGAGAG
GAATACCTTGCATCTCTTCGAAGAAAGAGTAGCGGTTTCTCAAGAGGAAT
CTCTAAATACCGTGCGCTTTCAAGTCGATGGGAACCATCATTTGGTCGTA
TGGCCGGATCTGAGTACCTTAGCAGCATACATTATGGTCCAGGGGATGAT
CTAGCAACAGATAGTGAATTTGTAGGTAGTTTATGCTTTGAAAGAAAGAT
TGATTTCACAAATTATATCAAGTGGTGGGGTCCAAACAAAAATCGTCAAG
GAGAAGCTAGTGTTAAATCATCTGAAGATGCTAAATTTGGTTGTGTTGGA
GATCTTGGAGGTGAGCTTAAACCATTAGAATGGGCAGTCAAGACTACAGA
ACCATACCAGATGCCTCGGTTAGGGGTGTCACCCGAAGGAAAACAGCATA
AAAGTTCGAAAGTATCTGCCTTGAGCATCTTATCGCGGTCACCAGCATAC
AAGAGCTTGCAAGAGAAAGCATCGAAAAAAGAAGAAACCAATGCAGAAAA
TGATGAGAACAAAAACAAAAATACTATGAGTAAATTGGACTATGGCAAAG
CGATTGAGAAGTCTACTAATCACGATGGGGCGAGTGACAGATATGGCGCT
GAATTAGGAATGAGCGAAGGATTGTCTCTGCAGAGAAATATAAATATGTT
CCCGTTGTCTCCCCTTTTGAATGCGCCACTGCTGACCAATTACAACACCA
TCGATCCATTAGTCGATCCTATAATTTGGACATCGCTTGCTCCTGTTCTT
CCAGGTGGACTTTCTCGTACATCTGAGGTTACTAAGACTGAGACCAGTTC
ATCGTTCTCTTTATATCAGCAAGGAGAATAA - Nucleotide:
-
>CsAP2-10
ATGATGGCTTCTTCTTCCTCTGATCCTGGTTTAAAGCCGGAATCTAGTTC
CGGTGGCGGTGGTGGAGGAGAGACTTCGGAGGCTGTGATTGCGAATGATC
AGCTTTTGTTATACAGAGGATTGAAAAAAGCGAAGAAAGAAAGGGGTTGT
ACGGCCAAAGAGAGAATCAGTAAAATGCCTCCATGTGCTGCTGGAAAAAG
GAGCTCCATTTACCGTGGAGTTACCAGGTATGGGTGAGAAAGTGAGAGAA
TTTGGTCTGTTTGGTTACTGAGAAAATGATTGAATTGAGTTGGGTTTTAG
CTTGCTCTGTTTAGATTATAGGTTTTATCAGTGAGAGTATATTGTGTAAA
GTTTGAATTTTTATTAGTAGTGAAAGGCAAGAACTGTATGGAGTGTTGAG
AATCATGGGGTTCCACTGATACCATGTTGAGAATCATGGGGTTCCATCTC
AAAACCAATTGGCAATGAGTGGAGTAGCCCATGTTCTTATATATGGCTCA
ATTCTCTACCATTTATTCCATGTGGGACATTGTCCACAATATGGAGAATT
GTAATTATGTTGATTTGAATTTGATGGTGTAATTTTATTGGGTATTTAGG
CATAGATGGACTGGTCGTTATGAAGCTCATCTTTGGGATAAAAGTACTTG
GAACCAAAACCAGAATAAGAAGGGAAAGCAAGGTTTTCATTCTCTATTCC
TCTCTCAATGAACATGTTTATATTATATGACTTGTAATTTTCATTGATGG
TTATGGAAAATCTTACATTAAACTCTTTTTTTGCATGGAATGGTTGGTCC
TGTTGATTCAAACATTCCAGTGTACTTGGGTATGTTGGTATCTTCACTTT
CATTTTAGTTCCTTTTTCCTTTTCAAATTTTCTAATTCTATGATAATATT
TCACATTGACAATCATTGAATAGCTTATTATTTACAGGGGCTTATGATGA
TGAGGAGGCTGCTGCTCGAGCTTATGATCTTGCTGCCTTAAAATATTGGG
GTCCTGGTACTCTAATTAACTTTCCAGTAAGATAGACAATTCCATAATCT
CTCTTGACCTTTTTATGAACCCTTTGATTCCAATTGATTCTCTGTGGTAT
TCTTTAAGAAATGTTAACAAACTTTTGTAGGTCACAGATTACGCGAGGGA
TCTTGAAGAAATGCAAAATGTTTCGCGAGAGGAATACCTTGCATCTCTTC
GAAGGTGTATATTTTACGTTTGCAATTCTATTTTTTATAGCCTGAATTTT
GTGCTGTAACTCAAGCGAAATGATCTTTACAGAAAGAGTAGCGGTTTCTC
AAGAGGAATCTCTAAATACCGTGCGCTTTCAAGGTGTGTTTTCAATATTG
AATATCCCTCATTTGTGTTGTACTCTCTCTTATTGTGCTCAGTAATGTGT
TTGATGCTGTTTTGGTACAGTCGATGGGAACCATCATTTGGTCGTATGGC
CGGATCTGAGTACCTTAGCAGCATACATTATGGTAAGTGATTTTTATCTA
ATTCATGTGATTCTCTAGAACTGAAAATAGTTGTTCACCACCCTTTATTT
TCCATTGAATTAAGCATTGTTTCTTCTCATATAAAGGTCCAGGGGATGAT
CTAGCAACAGATAGTGAATTTGTAGGTAGTTTATGCTTTGAAAGAAAGAT
TGATTTCACAAATTATATCAAGTGGTGGGGTCCAAACAAAAATCGTCAAG
GAGAAGCTAGTGTTAAATCATCTGAAGATGCTAAATTTGGTTGTGTTGGA
GATCTTGGAGGTGAGCTTAAACCATTAGAATGGGCAGTCAAGACTACAGA
ACCATACCAGATGCCTCGGTTAGGGGTGTCACCCGAAGGAAAACAGCATA
AAAGTTCGAAAGTATCTGCCTTGAGCATCTTATCGCGGTCACCAGCATAC
AAGAGCTTGCAAGAGAAAGCATCGAAAAAAGAAGAAACCAATGCAGAAAA
TGATGAGAACAAAAACAAAAATACTATGAGTAAATTGGACTATGGCAAAG
CGATTGAGAAGTCTACTAATCACGATGGGGCGAGTGACAGATATGGCGCT
GAATTAGGAATGAGCGAAGGATTGTCTCTGCAGAGAAATATAAATATGTT
CCCGTTGTCTCCCCTTTTGAATGCGCCACTGCTGACCAATTACAACACCA
TCGATCCATTAGTCGATCCTATAATTTGGACATCGCTTGCTCCTGTTCTT
CCAGGTGGACTTTCTCGTACATCTGAGGTTAGTATTTCTCGAAATCACTA
TTTAATTTTCTTAACATGACAGAATGAATACACATGATTGATAATCAAGA
ACACCATTATGGCAATATATGGAAGTATTATGGTAAACTATACCTTTTTA
AGTAGTAACAATTAATATGTTTATACCTTTTTGGACCGTGTGATTTATAA
AATCAACTTTGGGACCCTTTGATTTGTAAATAAATTATCAAATCCTAACA
TCATGTGATAAACTAAGAAATTCAAATGAAAGCAAGGAGGGATTTTTATA
TTTTTATTTTGTGTACAAGTTTGGATGCATTATAATAATAAAACTTGATG
ATATGGAAATGCAGGTTACTAAGACTGAGACCAGTTCATCGTTCTCTTTA
TATCAGCAAGGAGAATAA