View Summary Pdf File Gene model: Cs_Cb2.03g110560.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.03g110560.m01
- Gene Model:
- Cs_Cb2.03g110560.m01
- Description:
- CsAP2-09
- Family:
- AP2
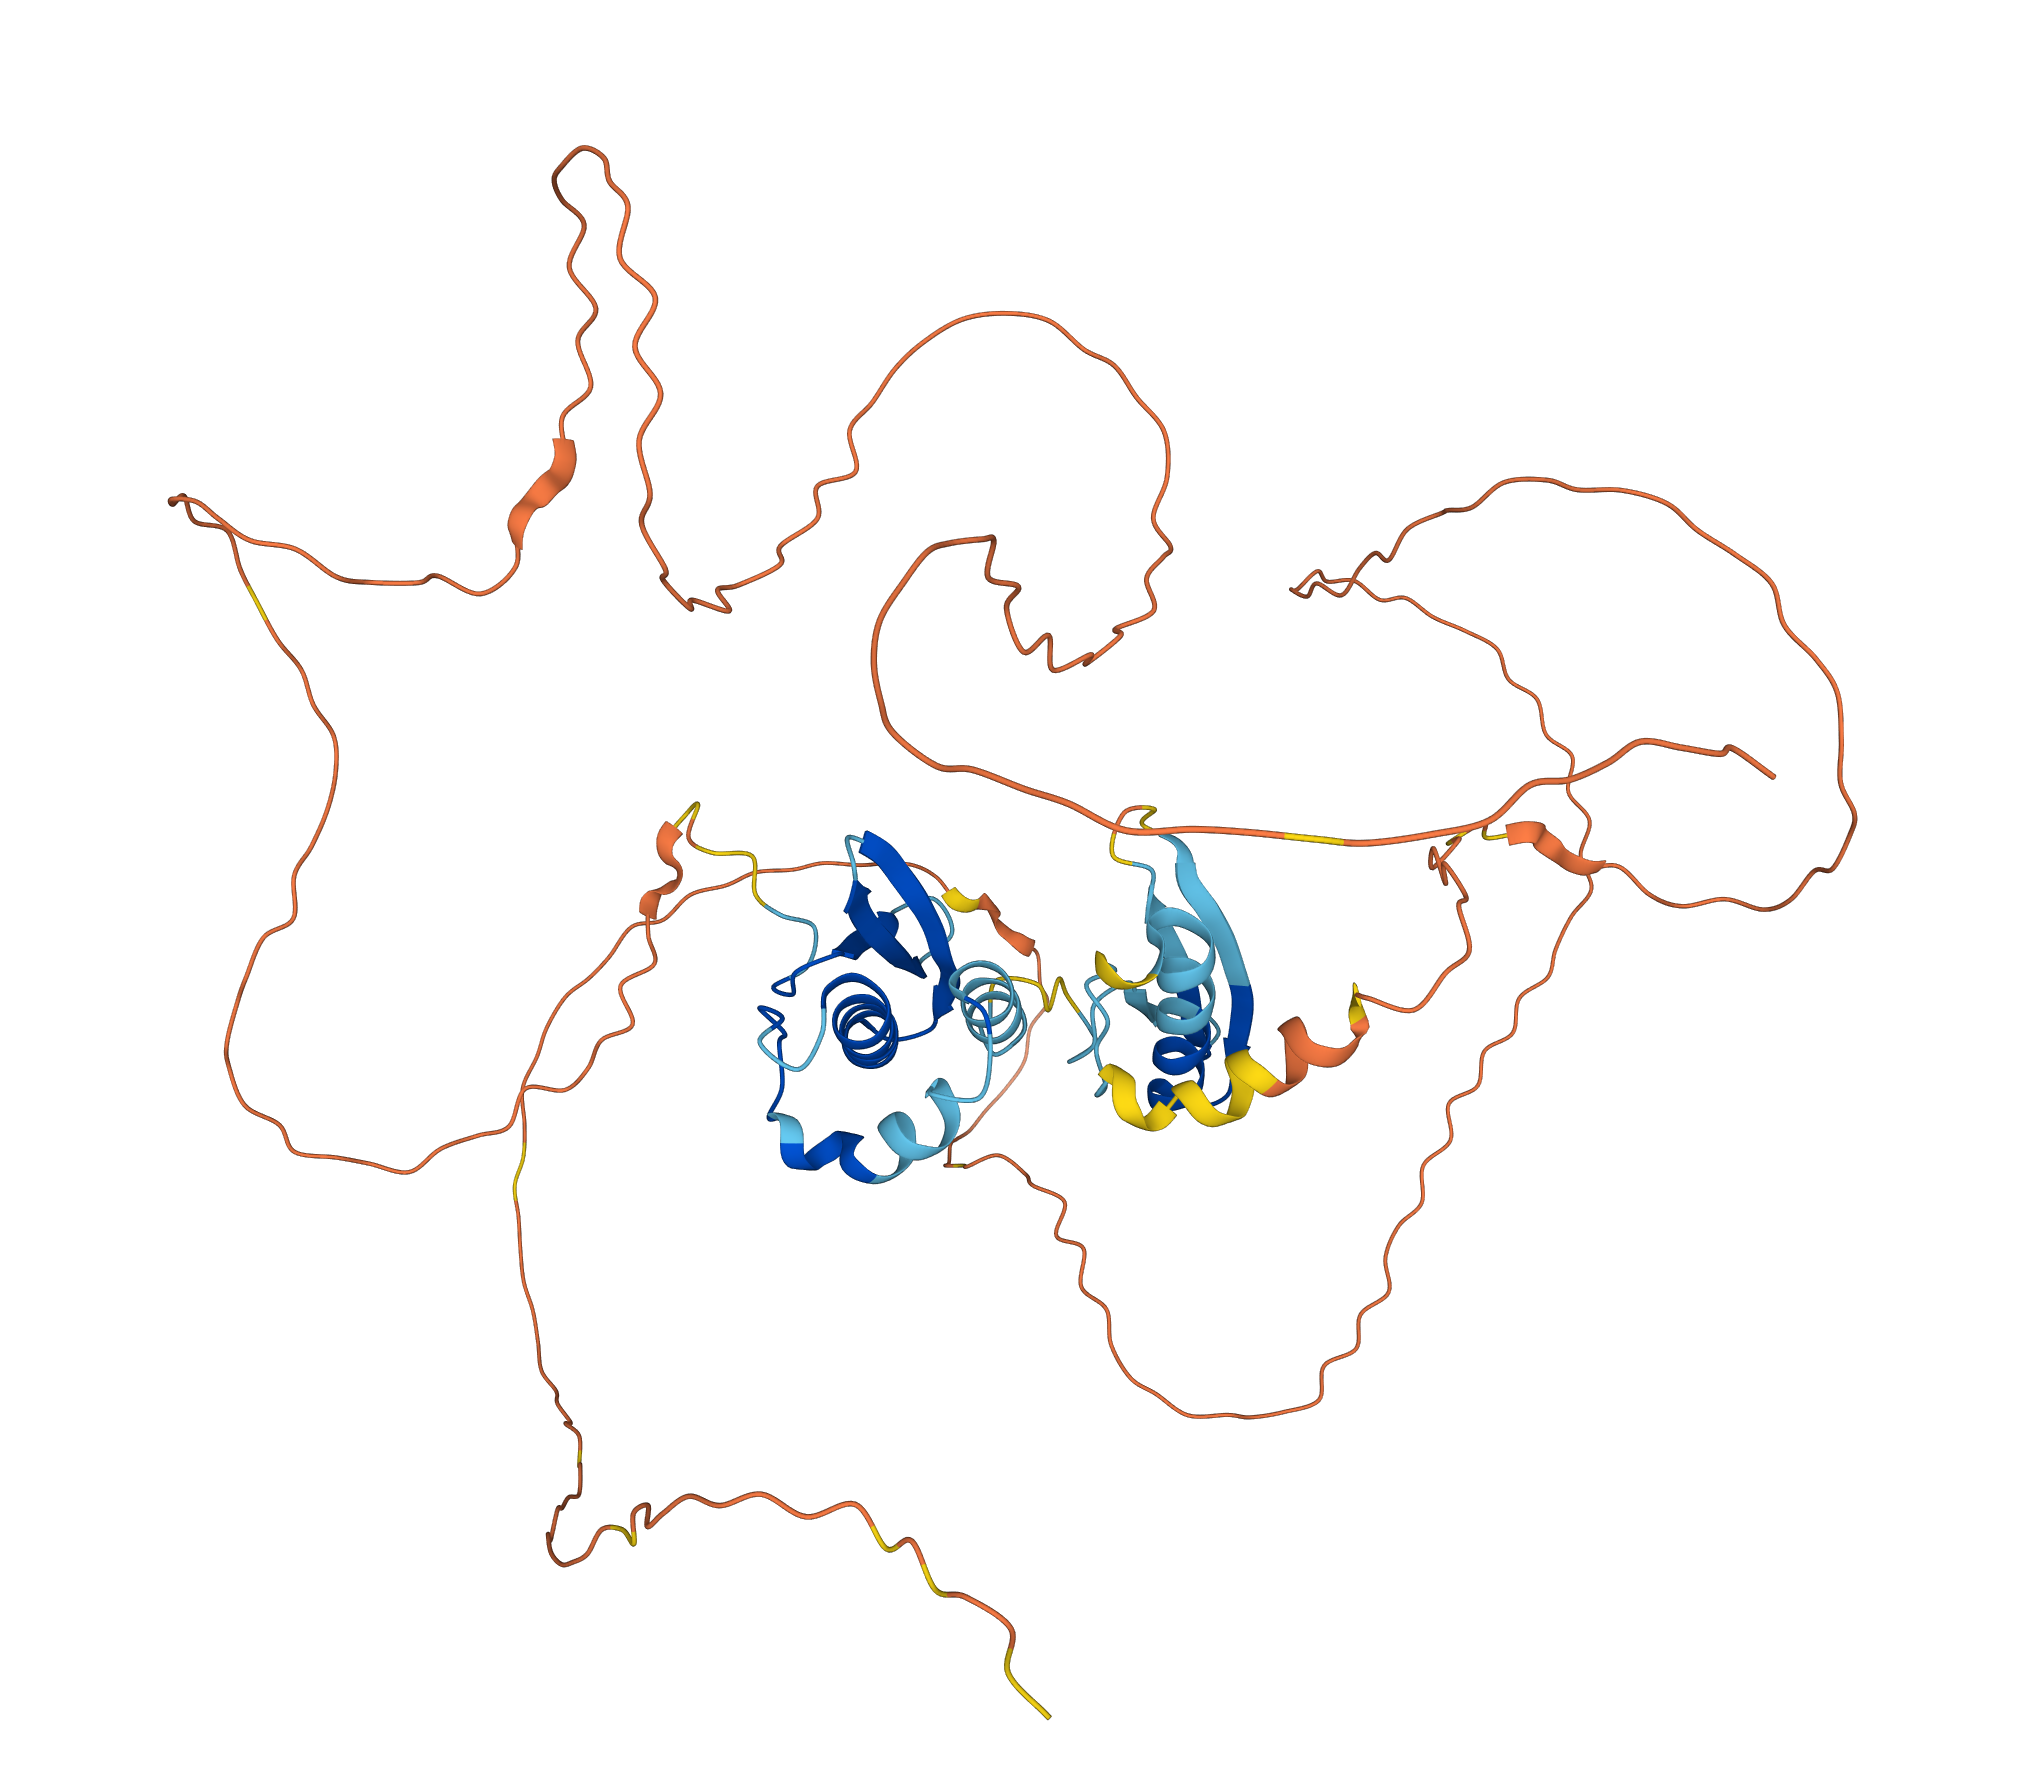
- 3D Structure:
- CsAP2-09
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-09
MLDLNLNVLLSPDSAASDSVDNKLLESSGSFNSSSNLTTADDDSSSNLNA
TASLFGYSFDILNNHRNDEVYVSTTNDHDVHRSCFAQTIELFPVANSINN
NNRSSVPRRQWLGLSCSEGTYGGPAEQGSAPQQQNKQVKKSRRGPRSRSS
QYRGVTFYRRTGRWESHIWDCGKQVYLGGFDTAHAAARAYDRAAVKFRGL
EADINFNISDYDEDIKH - CDS (Coding Sequence):
-
>CsAP2-09
ATGCTTGATCTTAATCTCAACGTCCTACTCTCTCCCGATTCGGCTGCTTC
CGATTCCGTCGACAATAAGCTTCTTGAGAGCTCCGGAAGCTTCAACTCCT
CTTCCAACCTCACTACCGCCGATGACGACTCTTCTTCCAACCTCAACGCA
ACTGCTTCTTTGTTTGGTTACAGCTTCGATATCCTTAACAACCACAGGAA
CGACGAAGTTTACGTCTCTACTACGAATGATCACGATGTTCATCGCAGCT
GTTTCGCTCAGACTATCGAGCTTTTTCCGGTGGCTAATAGTATCAACAAC
AATAATAGGTCGTCCGTACCGAGGAGGCAGTGGTTAGGTTTGTCTTGCTC
AGAAGGGACTTACGGTGGTCCAGCGGAGCAGGGAAGCGCGCCCCAACAAC
AGAATAAGCAGGTGAAGAAGAGTCGTAGGGGACCAAGGTCTCGAAGCTCC
CAGTATCGTGGGGTCACGTTTTATCGAAGAACGGGAAGATGGGAATCTCA
TATTTGGGATTGTGGGAAACAGGTTTACTTGGGGGGTTTTGACACAGCTC
ATGCTGCAGCCAGGGCTTATGATCGAGCGGCTGTCAAGTTTCGTGGATTG
GAAGCTGATATAAACTTCAACATCAGTGACTATGATGAAGATATCAAGCA
T
- Nucleotide:
-
>CsAP2-09
ATGCTTGATCTTAATCTCAACGTCCTACTCTCTCCCGATTCGGCTGCTTC
CGATTCCGTCGACAATAAGCTTCTTGAGAGCTCCGGAAGCTTCAACTCCT
CTTCCAACCTCACTACCGCCGATGACGACTCTTCTTCCAACCTCAACGCA
ACTGCTTCTTTGTTTGGTTACAGCTTCGATATCCTTAACAACCACAGGAA
CGACGAAGTTTACGTCTCTACTACGAATGATCACGATGTTCATCGCAGCT
GTTTCGCTCAGACTATCGAGCTTTTTCCGGTGGCTAATAGTATCAACAAC
AATAATAGGTCGTCCGTACCGAGGAGGCAGTGGTTAGGTTTGTCTTGCTC
AGAAGGGACTTACGGTGGTCCAGCGGAGCAGGGAAGCGCGCCCCAACAAC
AGAATAAGCAGGTGAAGAAGAGTCGTAGGGGACCAAGGTCTCGAAGCTCC
CAGTATCGTGGGGTCACGTTTTATCGAAGAACGGGAAGATGGGAATCTCA
TATTTGGTTTGTGATTATAGCTTCATATGCATTGAAACAATTCTCTTTTA
TTTTTGTGTTACTTTCTCTGAGTCATTTTGAAATTTTTGCAGGGATTGTG
GGAAACAGGTTTACTTGGGTAAGAACAAACAAAAATGATCAGAGAATTAT
ATTTTTCTTCTTTCTGACAGCCAGATTTATATATATATATATATATATGT
ATATATATATATTTCTGCATGTAATTTTAAATCTAATGCTCTATTCTCTG
TGATATGTTTAGGGGGTTTTGACACAGCTCATGCTGCAGCCAGGTACAGA
TAAGTCTTACCTATGATAATGGTGTATGTGGTAACAGTAGAGCCTTTCAT
GGAGTTTGAATGATGGAGATTTTGGGGTACGGGTTTTTGATTTTCAGGGC
TTATGATCGAGCGGCTGTCAAGTTTCGTGGATTGGAAGCTGATATAAACT
TCAACATCAGTGACTATGATGAAGATATCAAGCAT