View Summary Pdf File Gene model: Cs_Cb2.02g230150.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.02g230150.m01
- Gene Model:
- Cs_Cb2.02g230150.m01
- Description:
- CsAP2-08
- Family:
- AP2
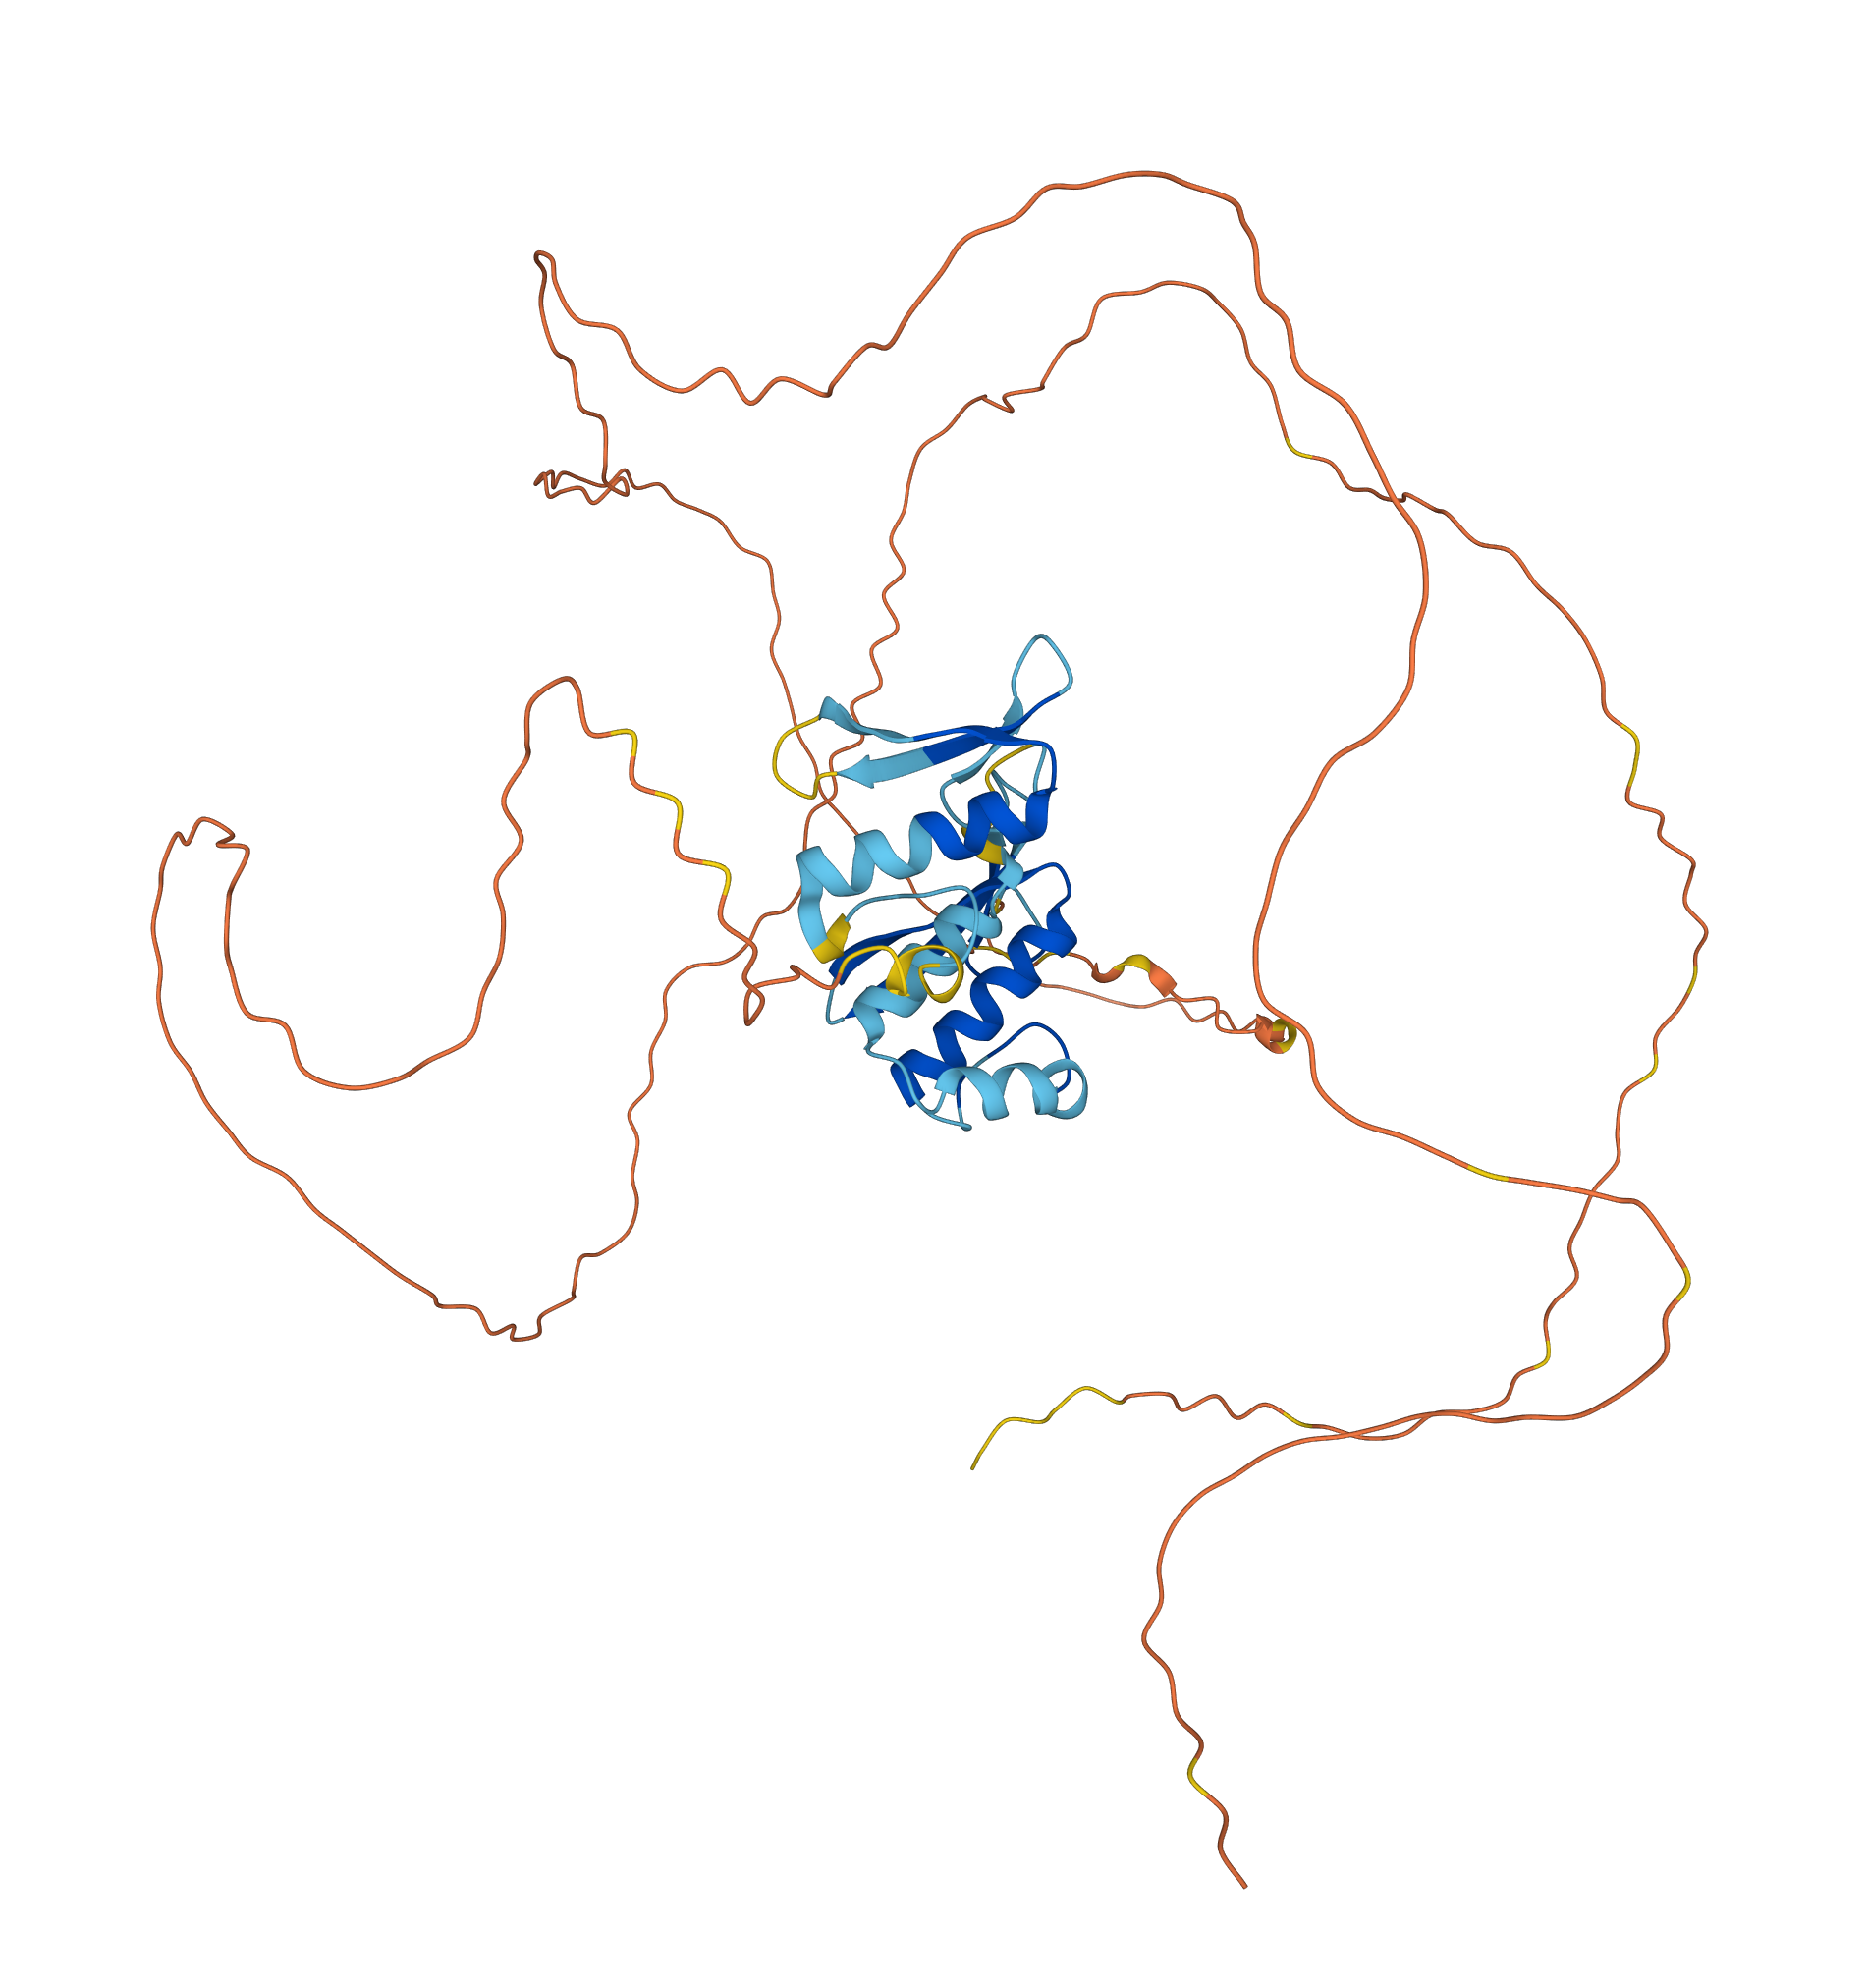
- 3D Structure:
- CsAP2-08
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-08
MTSRAPHAPVVSEVYTFSFDILKVGAENDVVVTKELFPMGGGGNGDFKDW
QGQLSSASSSSSSSRRNWIELGFDQSGSGEVRVLEAAPPLNPQPQPVKKS
RRGPRSRSSQYRGVTFYRRTGRWESHIWDCGKQVYLGGFDTAHAAARAYD
RAAIKFRGVDADINFNLSDYDEDLKQMKNLTKEEFVHILRRQSTGFSRGS
SKYRGVTLHKCGRWEARMGQFLGKKYIYLGLFDSEVEAARAYDKAAIKCN
GREAVTNFEPSDNHNLDLNLGMSTSSFGTCQKESEGRIQFHPGHYDVHNR
KPLGMENHSNATLGDPPFKGLVMTSEQQPLMLSGVYPSFFPNEERATDKR
IALGSSQGRPAWQMHGQVTANPVPLFSTAASSGFSFSAAPPSAAILSSKP
LNPGAHNLCFTSPNTGATNSPQYYYQVKPPQAPP - CDS (Coding Sequence):
-
>CsAP2-08
ATGACGAGTCGTGCTCCGCACGCGCCGGTGGTTTCCGAGGTGTACACGTT
CAGCTTCGATATCCTGAAAGTTGGGGCTGAAAACGACGTCGTGGTGACGA
AAGAGCTTTTCCCGATGGGTGGTGGAGGAAATGGAGATTTTAAGGATTGG
CAGGGGCAGCTTTCGTCGGCTTCTTCTTCTTCTTCTTCTTCGAGGAGGAA
CTGGATCGAGCTGGGGTTTGATCAGAGTGGGTCTGGTGAGGTGAGAGTGC
TTGAAGCGGCGCCGCCTCTAAACCCACAGCCACAGCCGGTAAAGAAGAGC
AGGAGGGGGCCCAGGTCTCGGAGCTCACAGTATAGAGGGGTGACCTTCTA
TAGGAGGACTGGAAGATGGGAATCGCATATCTGGGATTGTGGAAAACAAG
TGTATCTGGGTGGATTTGACACTGCCCATGCTGCGGCTAGAGCTTATGAT
CGAGCTGCTATCAAGTTCAGGGGAGTAGATGCTGATATTAATTTCAATCT
CAGCGATTATGACGAGGATTTAAAGCAGATGAAGAACTTGACCAAGGAAG
AGTTTGTACACATTCTACGCAGACAGAGCACTGGGTTCTCTAGGGGAAGC
TCAAAATATAGAGGAGTGACTCTGCACAAATGTGGCCGATGGGAAGCGCG
AATGGGACAATTCCTAGGCAAAAAGTATATATATCTTGGGCTATTCGACA
GCGAAGTAGAAGCTGCAAGGGCATATGATAAAGCAGCTATCAAATGTAAT
GGAAGGGAAGCAGTCACCAACTTTGAGCCAAGTGATAATCACAATCTTGA
TCTCAATCTGGGGATGTCCACCTCTTCATTTGGCACTTGTCAGAAGGAAA
GTGAGGGGCGTATCCAGTTCCACCCTGGGCATTATGATGTACACAACAGA
AAGCCTCTCGGGATGGAGAACCATAGCAATGCAACACTAGGCGATCCACC
TTTCAAAGGGCTCGTAATGACATCAGAACAACAACCGCTTATGTTAAGCG
GTGTATACCCTAGTTTCTTTCCTAATGAGGAAAGGGCTACAGACAAGAGA
ATTGCACTAGGTTCTTCCCAAGGACGTCCCGCGTGGCAAATGCATGGCCA
GGTTACTGCAAACCCAGTGCCACTGTTCTCTACTGCAGCATCATCAGGAT
TCTCATTTTCGGCCGCCCCTCCCTCCGCTGCCATTCTTTCATCAAAACCA
CTAAACCCGGGAGCCCATAATCTCTGTTTTACTTCTCCTAACACAGGCGC
CACCAATTCCCCACAATACTATTACCAGGTAAAGCCTCCCCAGGCACCGC
CATAG - Nucleotide:
-
>CsAP2-08
ATGACGAGTCGTGCTCCGCACGCGCCGGTGGTTTCCGAGGTGTACACGTT
CAGCTTCGATATCCTGAAAGTTGGGGCTGAAAACGACGTCGTGGTGACGA
AAGAGCTTTTCCCGATGGGTGGTGGAGGAAATGGAGATTTTAAGGATTGG
CAGGGGCAGCTTTCGTCGGCTTCTTCTTCTTCTTCTTCTTCGAGGAGGAA
CTGGATCGAGCTGGGGTTTGATCAGAGTGGGTCTGGTGAGGTGAGAGTGC
TTGAAGCGGCGCCGCCTCTAAACCCACAGCCACAGCCGGTAAAGAAGAGC
AGGAGGGGGCCCAGGTCTCGGAGCTCACAGTATAGAGGGGTGACCTTCTA
TAGGAGGACTGGAAGATGGGAATCGCATATCTGGTGAGTCAATTTCTTCT
TGAATTGTATTCAATAAGTGTTGTTTATTGTTTCGATGAAATTGGGTCTT
TGTTAAATCAAGTATGTGTATGGATTTCGATCATTCATTTGCTTAGTTCT
AATTGATAATTAATGCATTTATTGTATTTAAGCAATTCAGGGTTTCAACA
GGGAAATAAATAATATCTGTTAATTATAAATATATAGATATATATTATGA
TTCTGTTTACACCTTTGACTGACTATTTCTCCTTTTGTTTTTCTTCTTCT
TTGTCTTTTGTAAACCAGGGATTGTGGAAAACAAGTGTATCTGGGTATGG
ATTTAATTATTTTATTAGAGACTGACTTTTTTAAGTCTACCCATTTAGAA
AATTTTCTGTTACGATCTTCTATTTTTGGAAAACTTTGACGAATTTTGTT
TTTGGACCTTGCTTTAGGTGGATTTGACACTGCCCATGCTGCGGCTAGGT
AAATTTCTTCTTATATGCATTTGGGTTATTTGTTGTCTCAGTGTTTATCA
TATGCATTTGGTTGACTTGGGTTTTTGGATTTTAGAGCTTATGATCGAGC
TGCTATCAAGTTCAGGGGAGTAGATGCTGATATTAATTTCAATCTCAGCG
ATTATGACGAGGATTTAAAGCAGGTATTAATGTGATACTATTGTCACTGA
AAGAAATACTGAATACCCTTTTGTTTAATTTTGTGGGTGCTATAGTGCTA
TAAGACTTAAATTGTTCGCCTATTTGGTCATTTCTCAGATGAAGAACTTG
ACCAAGGAAGAGTTTGTACACATTCTACGCAGACAGAGCACTGGGTTCTC
TAGGGGAAGCTCAAAATATAGAGGAGTGACTCTGCACAAATGTGGCCGAT
GGGAAGCGCGAATGGGACAATTCCTAGGCAAAAAGTGAGGAACTATTTTA
AAAAATATTATCATTCAATTTATACTTCTGATAATGGAAGTTTATTATGC
CTTCATTGGTGTGAACTACAATTGTTACAAATTATTTCCTTTTTGGTTTT
CAATTTTTGTTGTTCTGTGTAAAACAAACTATCAAATATATTTCAATAAG
AAAAAAGAAGATGAAGAATGAATGAATGAATGAAAACAAAGAAAAAGAAA
CAGAAATTGGGGACCGCGTTTACATCATGGAGGTTACGATGCTTGCATGC
AGGTATATATATCTTGGGCTATTCGACAGCGAAGTAGAAGCTGCAAGGTC
CTAATGATCATGAATTACACTCTACCTGAAACTGAATTTATTACCTTCTC
AACCTCATTAGGCTTCCATCCAACACGTCTTCCTTTTGATTTTCTGGAAA
CCAGGGCATATGATAAAGCAGCTATCAAATGTAATGGAAGGGAAGCAGTC
ACCAACTTTGAGCCAAGTACCTACGAAGGGGAATGATTCCTACTGCCAAT
CATGAAGGTACTTTCTAATAGATAATTTCATAGGACCTTTTGTGATCATT
GTATAATATGCCGAAATGTTACAATTGTTAACGATTCTCTTATATGCAGG
TGATAATCACAATCTTGATCTCAATCTGGGGATGTCCACCTCTTCATTTG
GCACTTGTCAGAAGGAAAGTGAGGGGCGTATCCAGTTCCACCCTGGGCAT
TATGATGTACACAACAGAAAGCCTCTCGGGGTAACTAACAAAATCCTGTA
GCAAATGATGAATTTTTTCGCACTTTGTCTTGCATTCGTTTGTTTTCCAT
GTACTAACTGATACAATTGACAAAATTTAGCATTCTATAATCCCCCCCTT
TTTTTTTCCATCACAAAGGAATGACCAAAAAAAAATTATGATCAATATGT
AACATTGTATAAGCCATTTGTTTATGTACTATGCATTCTGGTTTTGTAGA
TGGAGAACCATAGCAATGCAACACTAGGCGATCCACCTTTCAAAGGGCTC
GTAATGACATCAGAACAACAACCGCTTATGTTAAGCGGTGTATACCCTAG
TTTCTTTCCTAATGAGGTAAAATTTCAATTAGCCTTCTGTCTGAACAATT
TCTCTATCCATATTTAGCCAAATAATGTTATTATAACAGTACAAAGTTCT
GACTAGAACCGAACGAGTCATGTAAATTACTCAGTCAAGTTATAAATTAG
GCAACTAATTTCTTTGCTCCTTATCTATAACATTAATGGACCATTCATTT
GGAAATGGTATAGCTTCAAAAATTAGTGTCTAAAAGTGTTCATAATATTA
GTAATTTAATTAGTTCATAATAACTCTTTAGCACCAACATCACGGATCTG
AGAACAAGCCATTACTATAGTACAAAATTTTCATAACATCAGACTGCTTG
TTCTGTTGTTGATATTGCCAATAATTCTTCTGGTAATTACATTCACTCTT
TAGAACCTTTTTTCTTGGGTGATGCTATTCATATTATATGCGAACAACCA
TTACTATACTTATAACTTCAAATTTAAATCCTAATATACAGGAAAGGGCT
ACAGACAAGAGAATTGCACTAGGTTCTTCCCAAGGACGTCCCGCGTGGCA
AATGCATGGCCAGGTTACTGCAAACCCAGTGCCACTGTTCTCTACTGCAG
CATCATCAGGATTCTCATTTTCGGCCGCCCCTCCCTCCGCTGCCATTCTT
TCATCAAAACCACTAAACCCGGGAGCCCATAATCTCTGTTTTACTTCTCC
TAACACAGGCGCCACCAATTCCCCACAATACTATTACCAGGTAAAGCCTC
CCCAGGCACCGCCATAG