View Summary Pdf File Gene model: Cs_Cb2.02g218730.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.02g218730.m01
- Gene Model:
- Cs_Cb2.02g218730.m01
- Description:
- CsAP2-06
- Family:
- AP2
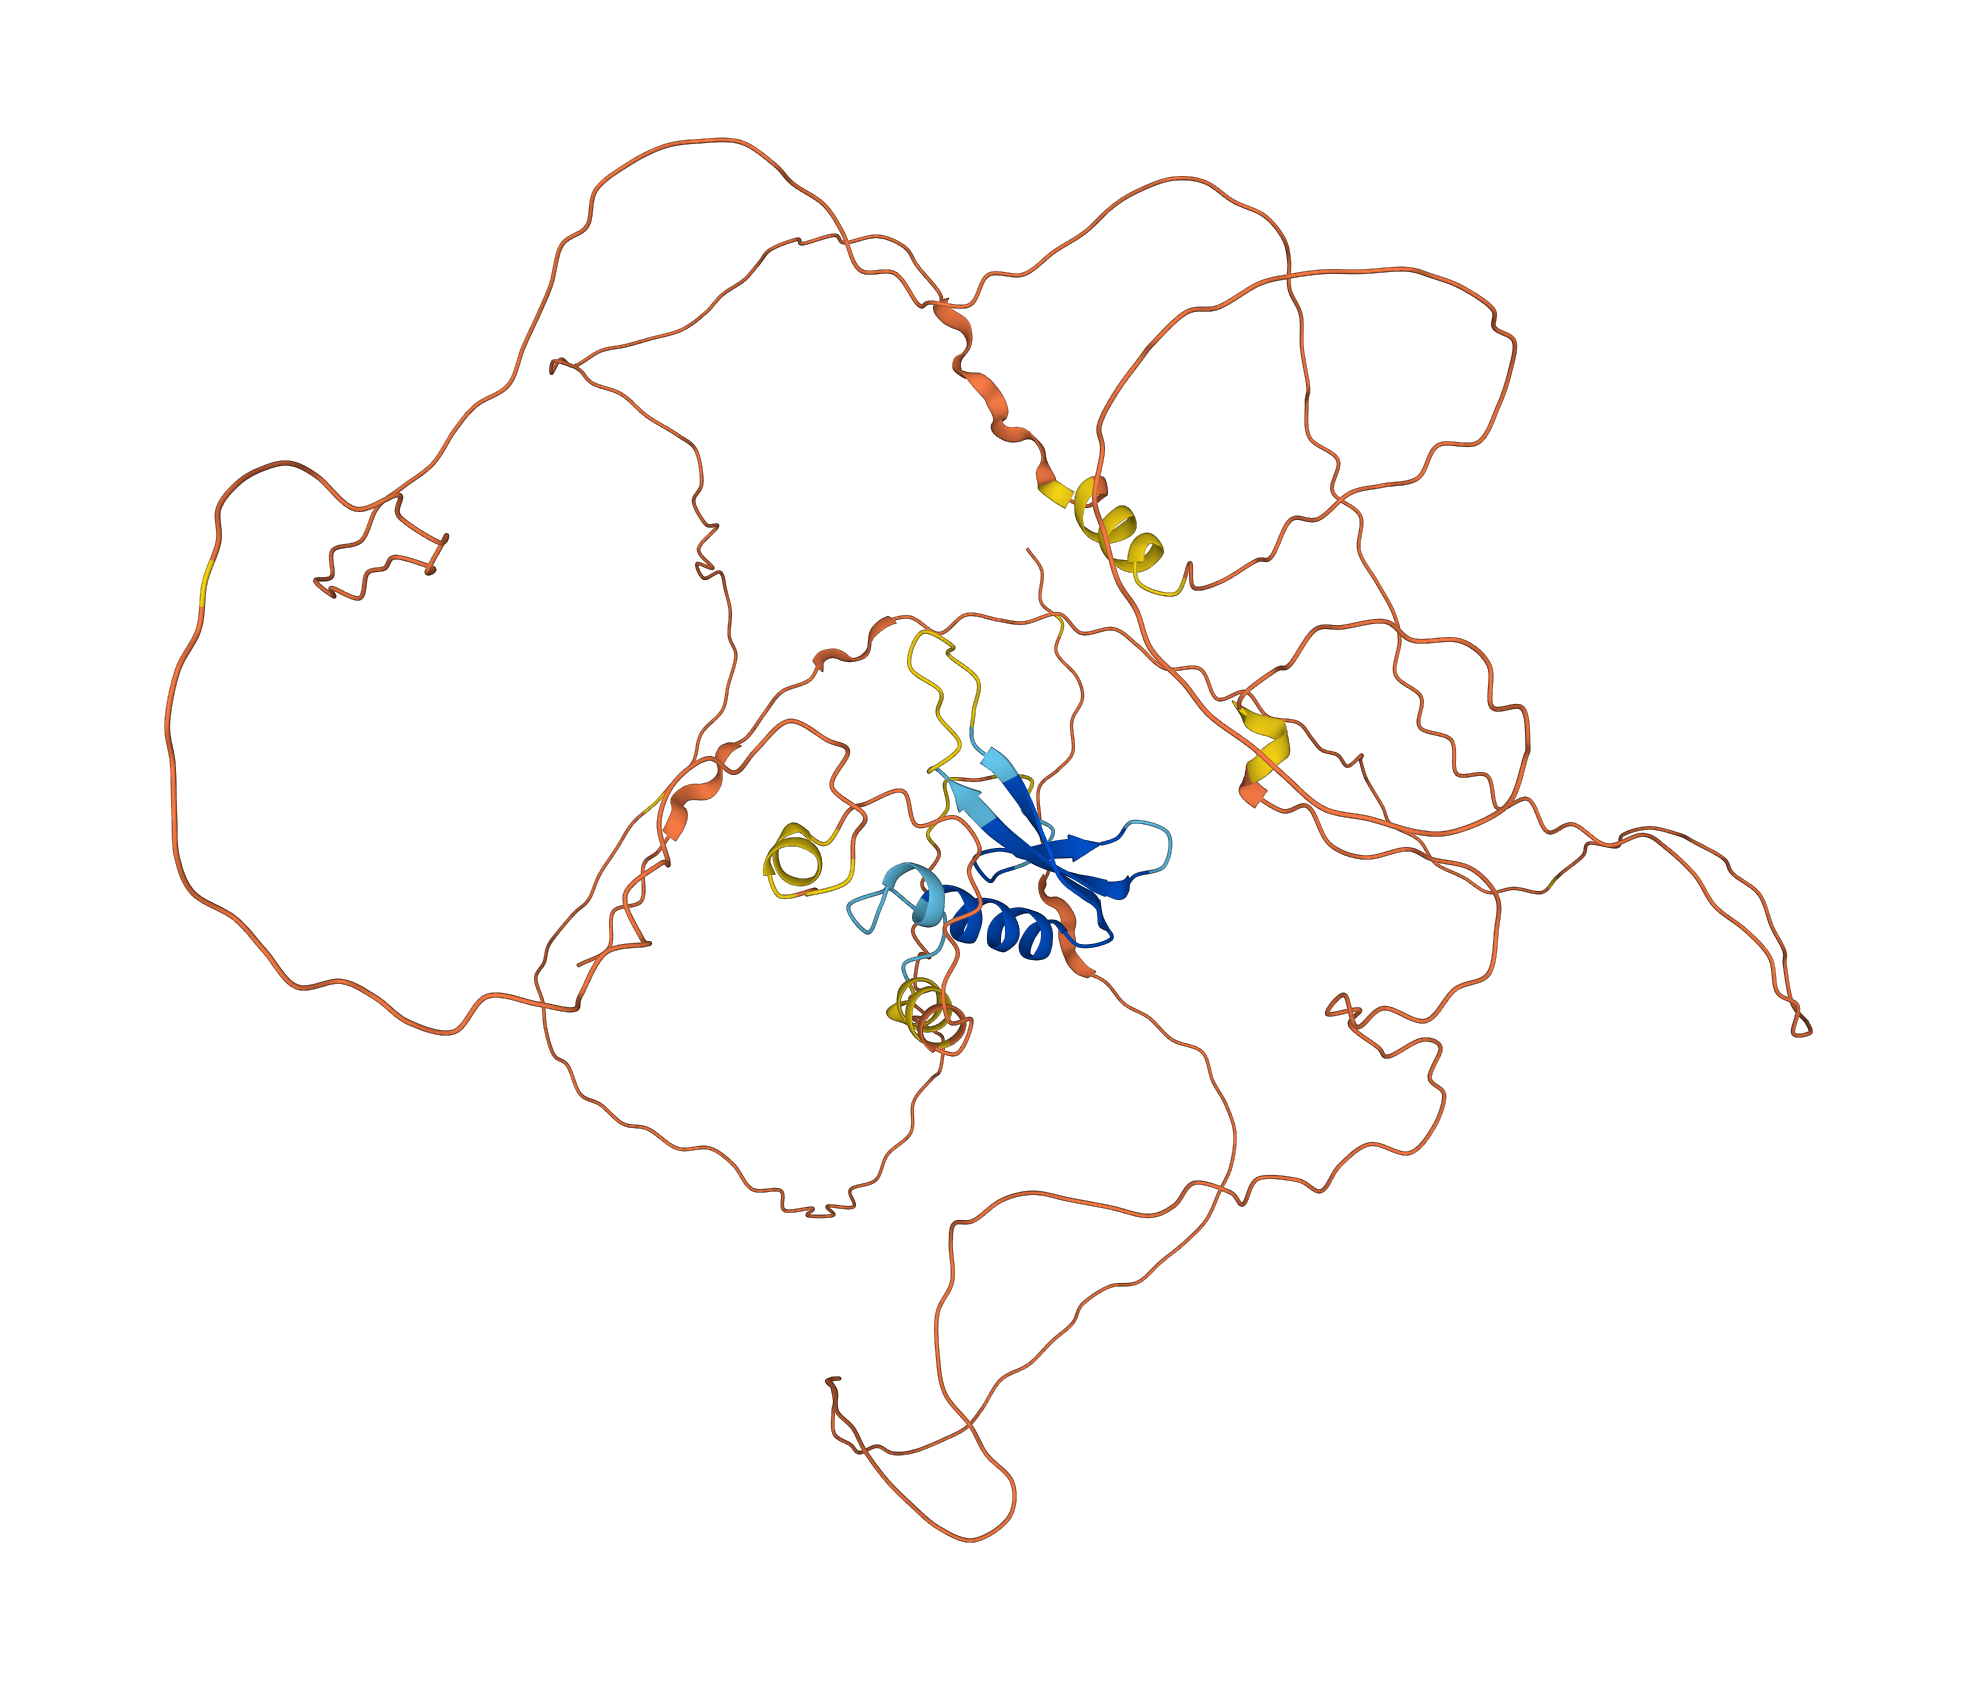
- 3D Structure:
- CsAP2-06
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-06
MGSMNWLGFSLSPQEPHHHQDHSQSTVSHHDHRLDGFNSDEISGNDVSGE
CFDLTSDHHSTHASFGILEAFNRSNNNNHSQDWNNMNSTNSSDFSMLMGS
NNNQNQQQHEQPKLENFLGRHSFADHHNTYNTSTTTADYMFQASCAASLN
ISSEAAVAAAAPSGVSAGVGGAAGSSIGLSMIKTWLRNQPAQTQPAETTT
NNKNDCSGGGGGGAGASYCGSDGGESSSISDNNKQPRTVTTVAVATAAGV
DSPTAAIEAVPRKSIDTFGQRTSIYRGVTRHRWTGRYEAHLWDNSCRREG
QTRKGRQVYLGGYDKEEKAARAYDLAALKYWGTTTTTNFP - CDS (Coding Sequence):
-
>CsAP2-06
ATGGGTTCTATGAACTGGTTAGGTTTCTCTCTTTCACCTCAAGAACCTCA
TCATCATCAAGATCACTCTCAGTCAACAGTCTCTCATCACGATCACCGCC
TTGATGGCTTCAACTCTGATGAAATCTCCGGAAACGATGTCTCCGGCGAG
TGCTTCGATCTCACTTCCGATCATCACTCCACTCATGCTTCTTTTGGCAT
ACTCGAAGCTTTCAACAGATCAAACAATAATAATCACTCTCAAGATTGGA
ACAATATGAACTCGACCAACTCATCGGACTTTTCTATGCTAATGGGAAGT
AATAATAACCAAAACCAACAACAACACGAGCAACCGAAGCTGGAAAACTT
TCTCGGCCGACACTCTTTCGCCGATCATCACAATACATACAACACTAGCA
CTACTACAGCCGACTACATGTTCCAAGCCTCATGCGCCGCTTCCTTGAAC
ATCTCATCCGAAGCCGCAGTCGCAGCCGCCGCGCCTAGCGGTGTAAGTGC
CGGAGTTGGAGGAGCTGCAGGAAGCTCCATTGGGCTGTCTATGATCAAGA
CGTGGCTTAGGAACCAACCTGCCCAGACTCAGCCGGCTGAGACTACTACC
AATAATAAGAATGACTGCAGCGGCGGTGGAGGAGGTGGAGCCGGTGCAAG
CTACTGCGGCAGCGATGGTGGGGAGAGTTCTTCTATATCGGATAATAATA
AGCAGCCTAGAACGGTAACGACAGTGGCGGTGGCTACGGCCGCTGGGGTT
GATAGTCCCACAGCCGCAATAGAGGCTGTGCCTAGAAAATCCATTGATAC
TTTTGGACAAAGAACATCTATATACCGTGGTGTAACCAGACATAGATGGA
CAGGTAGATATGAGGCTCATCTATGGGATAATAGTTGCAGAAGAGAAGGA
CAAACTCGCAAGGGAAGACAAGTTTACTTGGGTGGTTATGACAAGGAAGA
AAAGGCAGCTAGAGCTTATGATCTTGCAGCATTGAAATATTGGGGTACCA
CAACCACTACCAATTTTCCT - Nucleotide:
-
>CsAP2-06
ATGGGTTCTATGAACTGGTTAGGTTTCTCTCTTTCACCTCAAGAACCTCA
TCATCATCAAGATCACTCTCAGTCAACAGTCTCTCATCACGATCACCGCC
TTGATGGCTTCAACTCTGATGAAATCTCCGGAAACGATGTCTCCGGCGAG
TGCTTCGATCTCACTTCCGATCATCACTCCACTCATGCTTCTTTTGGCAT
ACTCGAAGCTTTCAACAGATCAAACAATAATAATCACTCTCAAGGTCCCT
ATTCCCTTTTCTTCCCTATAAACAAACACACACACACACATACATAATGA
ACATATATCCCTATTTAAGTTAAGTCCCTTATTTATTTATTTATTTATTT
GCTTGCAGATTGGAACAATATGAACTCGACCAACTCATCGGACTTTTCTA
TGCTAATGGGAAGTAATAATAACCAAAACCAACAACAACACGAGCAACCG
AAGCTGGAAAACTTTCTCGGCCGACACTCTTTCGCCGATCATCACAATAC
ATACAACACTAGCACTACTACAGCCGACTACATGTTCCAAGCCTCATGCG
CCGCTTCCTTGAACATCTCATCCGAAGCCGCAGTCGCAGCCGCCGCGCCT
AGCGGTGTAAGTGCCGGAGTTGGAGGAGCTGCAGGAAGCTCCATTGGGCT
GTCTATGATCAAGACGTGGCTTAGGAACCAACCTGCCCAGACTCAGCCGG
CTGAGACTACTACCAATAATAAGAATGACTGCAGCGGCGGTGGAGGAGGT
GGAGCCGGTGCAAGCTACTGCGGCAGCGAGTACAACTACTCATCAGACTC
TTTCTCTGTCTATGAGTACTGGATCGCAGTCTAGCTCAGCTTTGCCTCTT
CTTACGACTGGGAGTGGTGGGGAGAGTTCTTCTATATCGGATAATAATAA
GCAGCCTAGAACGGTAACGACAGTGGCGGTGGCTACGGCCGCTGGGGTTG
ATAGTCCCACAGCCGCAATAGAGGCTGTGCCTAGAAAATCCATTGATACT
TTTGGACAAAGAACATCTATATACCGTGGTGTAACCAGGTCACTTTCTCA
TATATATATATATATGCAGGCTTACTTTTTTTTTTTTGCCTTTCTTTCTC
TCTTATTATTTTTCTTGTTATTAAATTTTAAACATTTGGTTTTGGAATTT
TTTTCAGACATAGATGGACAGGTAGATATGAGGCTCATCTATGGGATAAT
AGTTGCAGAAGAGAAGGACAAACTCGCAAGGGAAGACAAGGTAGAGTTTT
ATGTAAATATGTATAAATCTATAAACTCACTTGATTTTCACTTAAGAAAA
ACGATTTTATATCAAATATATAAACTAATTGTGATTCTTTTTTTTTCCCT
TTCTGATGTGGCTCTTATTCTCCTCAATCTTCCTATATATATGATCATCT
TCTTGGTTTGGGGCTTTGATCATGTCATCATTATCATTATAATGATAACC
CTCTGCAGTTTACTTGGGTAAGCACTAAAGTAATAGCAAGTTATTTCTTC
ATCAAAATATCAGTAAGTTTTTATTTGTTTCTTGTTCATGATCTTATCTC
TCTTTTAAATTTATATAAAACAGGTGGTTATGACAAGGAAGAAAAGGCAG
CTAGAGCTTATGATCTTGCAGCATTGAAATATTGGGGTACCACAACCACT
ACCAATTTTCCT